前言
向量数据库在 AI 与大模型(LLM) 领域中是个至关重要的组件,主要承担”记忆与检索”的角色,其解决了大模型不能长期存储海量知识、推理效率受限的问题,无论是 RAG、推荐系统还是智能搜索,向量数据库都提供了”相似度搜索”的能力,让模型能找到相关上下文,而不仅仅依赖参数记忆。这其中,pgvector 则是个比较独特的存在,选择站在 PostgreSQL 的基础上,高屋建瓴,而不是另起炉灶。随着版本的不断革新,pgvector 正在从一个实验性扩展,成长为 PostgreSQL 生态中”通用的向量搜索引擎”,成为 LLM/RAG/AI 应用的基础组件。
Roadmap
从 pgvector 的 roadmap 中,不难看出,pgvector 在规模化落地场景下,不断在尝试与优化,pgvector 正在从”能用”走向”高效、可扩展、适合大规模 AI 应用”的阶段。
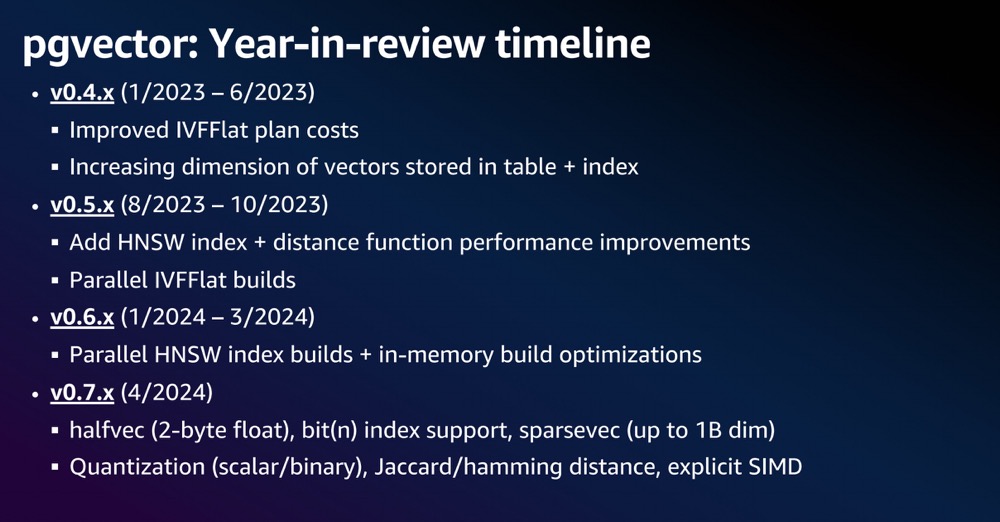
v0.4.x:
- 改进 IVFFlat 计划代价估算:优化了执行计划的成本模型,让查询优化器更合理地选择是否使用 IVFFlat 索引。
- 增加向量维度上限:支持更高维度的向量存储,无论在表还是索引中,都能容纳更大维度的 embedding。
v0.5.x:
- 新增 HNSW 索引:引入 Hierarchical Navigable Small World 图索引,大幅提升高维向量相似度搜索性能。
- 距离函数性能优化:加快余弦、内积等相似度度量的计算速度。
- 并行 IVFFlat 构建:支持并行化创建 IVFFlat 索引,提高大规模索引构建效率。
v0.6.x:
- 并行 HNSW 构建:在 HNSW 索引上引入并行化构建机制,适合海量数据集场景。
- 内存构建优化:提升了索引构建时的内存使用效率,加快索引建立速度并减少资源消耗。
v0.7.x:
- halfvec 类型:支持 2 字节浮点(半精度 float16),节省存储空间并加快计算。
- bit(n) 索引支持:支持对 bit 向量进行索引。
- sparsevec 类型:稀疏向量支持,维度上限可达 10 亿,适合大规模稀疏 embedding。
- 量化(Quantization):支持 scalar/binary 量化,进一步压缩存储和加速检索。
- 新距离度量:支持 Jaccard / Hamming 距离。
- 显式 SIMD:利用 CPU SIMD 指令集进行加速。
v0.8.x:
- Iterative Index Scan:提升带过滤条件查询时的召回率。
- HNSW 优化:改进索引构建与查询性能。
- 云平台支持:如 Aurora、Cloud SQL 等主流云服务都已集成。
迭代扫描
0.8.0 中的迭代扫描,是我十分喜欢的特性,在 ANN 场景中,我们往往不会在全表里暴力搜索,而是要加上过滤条件,再在符合条件的数据里做向量相似度计算,但是这样就会遇到典型的 pre-filter 和 post-filter 的问题:
- Pre-filtering:先应用业务过滤条件,然后在过滤后的子集里做向量相似度检索,检索空间小,结果更符合业务语义;但是只能用暴力搜索,因为过滤后的子集不再能直接利用 ANN 索引 (IVFFlat/HNSW);缺乏可扩展性,大规模数据下速度慢;
- Post-filtering:先在全量数据里使用 ANN 索引做向量近似搜索,得到候选集合,再对结果应用业务过滤条件。好处是能用上 ANN 索引,查询速度快,适合大规模数据;但可能会导致过滤后结果不足。
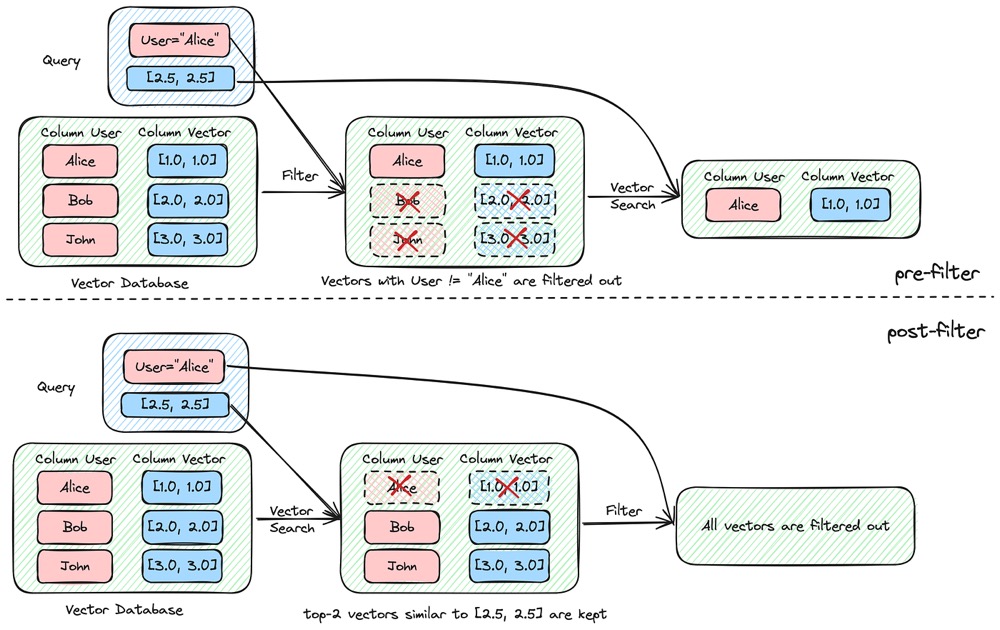
pgvector 0.8.0 引入的 Iterative Index Scans,其实就是为了解决刚才提到的 Post-filter 与 Pre-filter 的矛盾,一个折中方案,先用 ANN 索引检索一批候选 (例如 Top-K),再应用过滤条件。如果过滤后结果还不够,就继续从索引里取更多候选,再过滤,直到得到足够的结果,或者索引没有更多候选。这样的话,好处十分明显:可以用上 ANN 索引(速度快),并且保证过滤条件被应用,同时还避免了 Post-filter 一次性取 N 条候选但可能不够的情况,大幅提升了带过滤条件的向量查询在 PostgreSQL 里的可用性和扩展性。
量化
0.7.0 以后还支持 Quantization 减少索引的大小,量化在实际应用中是一种存储与性能的平衡手段,适合大规模 embedding 场景。量化是指将高精度浮点向量压缩成更低精度的表示,以减少存储和加快计算,代价是精度损失(Recall 降低),但通过 rerank可恢复精度。其中量化又分为:
- Scalar Quantization (标量量化):例如把 4 字节 float 压缩成 2 字节 half-float,甚至 1 字节整数。
- Binary Quantization (二值量化):将向量编码为比特串,用汉明距离比较。
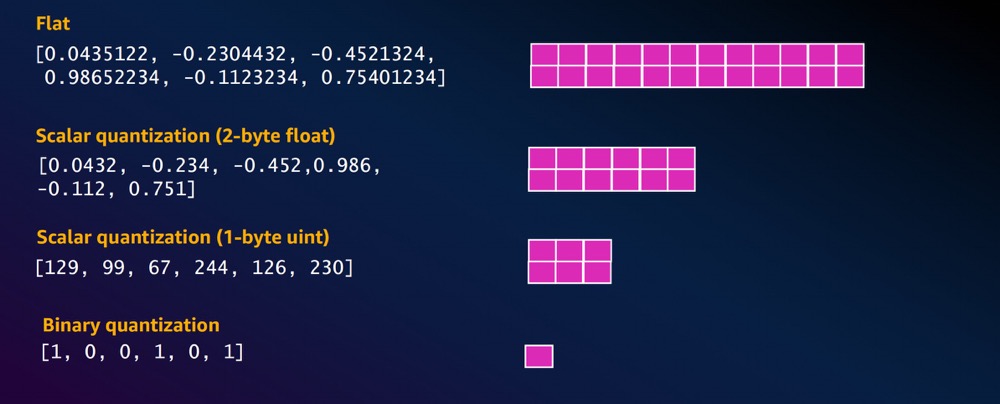
根据实验,Scalar (2-byte float):索引大小减半 (7.7GB→3.8GB),查询速度稍有提升,Recall 几乎不变。Binary:索引极小 (7.7GB→0.47GB),构建速度更快,QPS 大幅提高,但 Recall 降低,需要 rerank 补偿
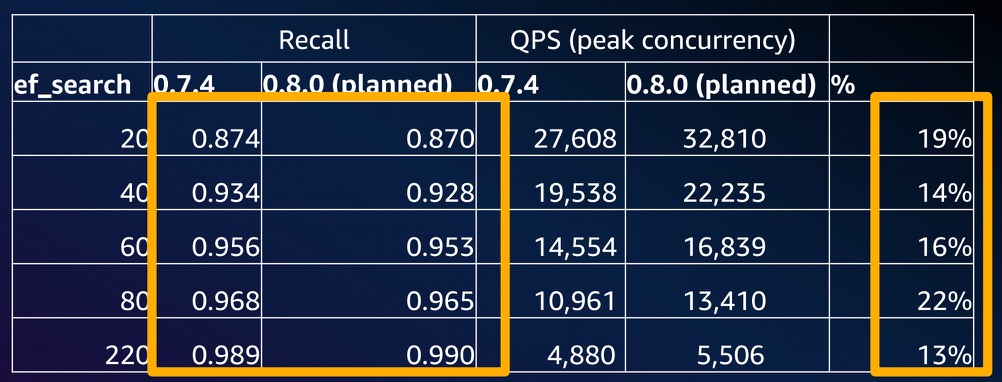
IVFFlat Index Vs. HNSW Index
另外一个老生常谈的问题便是索引的选择了,什么时候选择 IVFFlat?什么时候选择 HNSW?
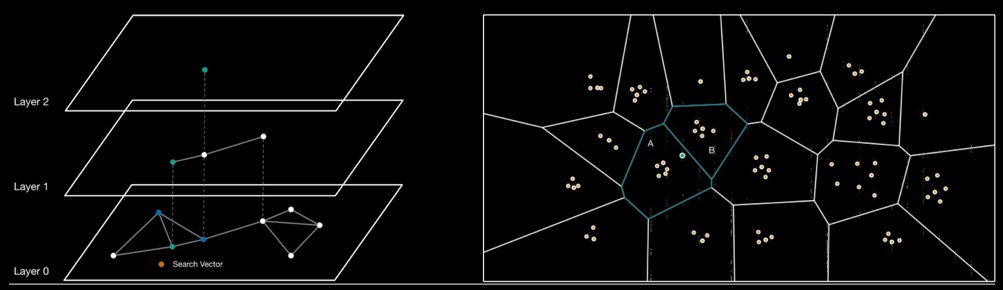
IVFFLAT:
- 建索引时需要训练步骤,即必须有一定数量的数据;
- 插入新数据后,如果分布发生变化,索引可能需要重建,尤其是频繁变更的场景,需要定期重建;
- 检索速度快,但召回率受限于簇的划分与搜索范围(由 probes 参数控制)。
- 典型场景:离线批量语义搜索、企业知识库、冷数据索引。
HNSW:
- 不需要聚类训练,可以随时插入;
- 插入时间会随着数据量增加而变慢;
- 查询速度和 recall 表现优异;
- 索引体积和内存消耗较大。
- 典型场景:在线推荐、对话检索(RAG)、个性化搜索、需要低延迟的实时应用。
其中在创建 HNSW 索引的时候,还有 m 和 ef_construction 选项:m 用于控制索引图的稠密程度(每个点的邻居数);ef_construction 则是用于控制建索引时的候选规模,影响建图质量与召回率;就像“面试时你愿意筛选多少简历”。筛得越多,找到最佳候选的概率越大,但耗费的时间也越多。两者都越大,召回率越高,但内存和构建开销越大。
为什么是 2000 维的限制
好问题 👍 这个限制正好和你刚才让我读的 Vector storage + TOAST 背景 紧密相关。原因主要有三个方面:
- PostgreSQL Page 大小的物理限制
- PostgreSQL 的基本存储单元是 8KB Page。
- 一个
float4(4 字节),2000 维的向量就是2000 × 4B = 8000B,刚好接近 8KB。 - 如果超过 2000 维,比如 3000 维:
3000 × 4B = 12KB,已经超出单个 Page 的容量。
👉 索引页不能使用 TOAST,所以如果 embedding 超过 2000 维,根本没办法存进索引结构,只能放在表的 TOAST 里(但 TOAST 不支持索引)。这就是为什么 pgvector 索引维度要限制 ≤2000。
- TOAST 对向量索引不可用
- TOAST 机制可以解决表中字段过大的问题(把大字段单独存储)。
- 但是 索引存储不支持 TOAST,所以一旦向量太大,就无法建立有效的 ANN 索引(IVFFlat/HNSW)。
- 即使强行存,也会导致索引构建失败或严重性能下降。
👉 根本原因:PostgreSQL 索引必须在 Page 内完整存储 key,而 embedding 超过 2000 维就放不下。
- 查询性能与工程权衡
- 高维度 embedding 本身就存在 维度灾难,查询效率下降。
- 超过 2000 维不仅难以存储,还会带来:
- 索引构建时间过长
- 内存/磁盘占用暴增
- 召回率下降,反而不一定比低维 embedding 好
- 因此 pgvector 做了一个“合理工程限制”:2000 维以下既能满足大多数模型(如 OpenAI 的 1536d embedding),也避免了超大向量带来的存储和查询问题。
🔹 结合你给的背景总结
- 本质原因:PostgreSQL 8KB Page 限制 + 索引不能用 TOAST。
- 表象结果:>2000 维 embedding 无法放进索引页 → pgvector 直接限制维度。
- 工程意义:2000 维是一个安全上限,兼顾存储、查询性能和实用性。
向量数据库在 AI 应用中的价值
- 增强知识覆盖:让 LLM 具备外部知识扩展能力。
- 提升响应质量:通过相关性检索,减少模型幻觉(hallucination)。
- 支持多模态:不仅支持文本,还能存储图像、音频、视频 embedding,用于跨模态检索。
- 实时性:随时插入新知识,立即可查,无需等待模型再训练。
- 高效召回:通过 HNSW、IVFFLAT 等索引结构,在亿级数据规模下仍能保持毫秒级查询。
索引说明
🧱 想象你在建一个“朋友关系图”
HNSW 索引就像是把所有向量(数据点)变成一个个“人”,
然后让每个人去认识一群“朋友”,朋友之间互相连线,最后形成一个“多层的朋友圈地图”。
以后你要找“最相似的向量”,就像:
“从图的入口开始,通过认识的人,不断往更像的方向走,直到找到最像的那几个”。
1️⃣ m:每个人最多交几个朋友(图的稠密程度)
1 | CREATE INDEX ON items USING hnsw (embedding vector_l2_ops) WITH (m = 16); |
👉 m 控制的是:每个数据点在 HNSW 图中最多可以连多少条“边”(也就是它最多能认识几个“朋友”)。
- m 越小
- 图比较“稀疏”,每个人认识的人少,找相似向量的时候路可能不太好走,有点像“问了几个人都不太知道方向”
- 索引体积小、建得快,但查找时精度可能下降
- m 越大
- 每个人认识的朋友多,图更“密”,路径更丰富,更容易快速找到真正最相似的点
- 但建索引会更慢,占更多内存,因为“每个人的朋友圈”都要存下来。
📌 比喻:
想象你在一个社交网络里找一个人。
如果每个人只认识 2~3 个人(m 很小),你可能要绕很久才能找到目标;
如果每个人都认识 20 个人(m 比较大),信息传播更快,你也更容易找到目标的人。
👉 常用 m:16~48,m=16 是常见的默认折中值。
2️⃣ ef_construction:建索引时,每个人找朋友有多“认真”
1 | CREATE INDEX ON items USING hnsw (embedding vector_l2_ops) WITH (ef_construction = 64); |
👉 ef_construction 控制的是:
在给一个新点选朋友的时候,它愿意先“考察”多少个候选人,再从中挑出最合适的 m 个朋友。
也就是:
- 每加入一个新数据点,HNSW 会先在图里搜索一圈,找到 ef_construction 个最相近的候选点;
- 然后从这堆候选里挑出最合适的 m 个朋友来连线。
- ef_construction 越大
- 新点加入时会“更认真地找朋友”,选出来的朋友更靠谱 → 整个图的质量(后面搜索精度)就更好
- 但建索引的时候会更慢、占更多内存
- ef_construction 越小
- 加入得很快,但可能交的朋友不太合适 → 图整体的“导航能力”就差一点,查询时可能更容易漏掉相似的点
📌 比喻:
你搬到一个新城市(插入一个新向量),你想认识朋友:
- 如果 ef_construction 很小,你只在小区随便认识几个人(快但不一定合适);
- 如果 ef_construction 很大,你可能跑遍整个城里认识一圈,最后挑出最合得来的那几位(慢,但质量高)。
👉 常用 ef_construction:64 ~ 200,
ef_construction=64 是一个不错的起点;
如果你数据量大、对召回率要求高,可以调到 100~200 甚至更高。
📝 小结一张表
| 参数 | 含义 | 增大后的效果 | 代价 |
|---|---|---|---|
| m | 每个点最多连几条边(认识几个朋友) | 图更密,查询更准 | 索引更大、建索引更慢 |
| ef_construction | 建索引时找朋友的“认真程度” | 图质量更高,查询精度更好 | 建索引更慢,占更多内存 |
🌟 一个形象的比喻总结
你在建一张“城市导航图”(HNSW 索引):
m决定每个路口连出去的路有几条(路网密不密);ef_construction决定修路的时候,城市规划者愿意考察多大范围来选最佳路线(规划质量高不高)。
建得越“精”,后面开车(查询)就越容易直接找到目标;
建得太“草率”,可能后面绕来绕去都找不到正确的方向。
要不要我给你画一张小图,把 m 小 vs m 大、ef_construction 小 vs 大的图结构对比画出来?(很直观 👀)
小结
通过 ROADMAP 我们不难看出:
- 索引能力仍是最核心的主线:IVFFlat → HNSW → 并行化 → 内存优化 → 迭代扫描
- 高性能与扩展性并行发展:v0.5.x 开始引入 并行构建;v0.6.x 继续推动 内存与并行优化;v0.7.x 则在硬件加速 (SIMD)、数据压缩 (量化)、大规模稀疏向量上发力。从单机可用,逐步走向支持大规模、高吞吐、可扩展部署,适合工业级应用场景
- 数据类型和应用场景在拓宽:v0.7.x 引入了 halfvec(float16)、sparsevec、bit(n) 等多样化类型,甚至支持 10 亿维的稀疏向量,支持新的距离度量(Jaccard/Hamming),不再局限于传统的 L2/内积/余弦,说明 pgvector 正在从”文本 embedding”走向多模态应用(文本、图像、音频、二进制特征),应用范围越来越广
- 存储压缩与计算加速成为新方向:v0.7.x 开始引入 量化 (scalar/binary),显然是为了解决存储空间与计算速度的矛盾,显式 SIMD 则说明团队在尝试利用底层硬件优化计算,未来版本会更注重 高维、大规模 embedding 的低成本存储和高效计算,这是和 Milvus/FAISS 等向量数据库竞争的关键
- v0.8.x 开始大规模进入 Aurora / Cloud SQL / Supabase 等云数据库生态:pgvector 不仅仅是一个扩展,它正在变成 PostgreSQL 的“标配能力”,走向主流云数据库平台。
pgvector 正在从一个实验性扩展,成长为 PostgreSQL 生态中”通用的向量搜索引擎”,成为 LLM/RAG/AI 应用的基础组件。根据奥卡姆剃刀原理,PostgreSQL 以其先进性、可扩展性等,当之无愧为 AI 时代的数据库首选。
参考
https://github.com/pgvector/pgvector
Best practices for using pgvector
PostgreSQL 上的向量搜索实践
评论区按需加载,正文阅读不会被第三方服务拖慢。